DeepSeek Harness:一切皆插件的 Agent 框架
 Ryan
本文目录
它是什么
DeepSeek Harness(简称 dsh)是 DeepSeek AI 开源的 Agent 运行框架(agent harness),MIT 协议。
它的核心理念浓缩成一句话,就是仓库标语写的:
Everything is a Plugin.
一切皆插件。
所谓 "harness"(马具/线束),官方给出的定位很直白:「Model + Harness = Agent」。
模型是「灵魂」,harness 是「身体」——harness 负责把模型接入真实世界:读文件、跑命令、调工具、写日志、接受审批。
一句话记住这个差异:LangGraph 让你在写死的引擎上画图,而 dsh 连引擎本身都做成了插件。
- LangChain(LCEL):给你一套链式管道,
A | B | C串起来跑线性流程(RAG、简单问答)。拓扑写死,没有循环。 - LangGraph:给你「图 + 状态」,节点和边随你定义,能循环、能分支、能中断恢复。但执行引擎是它写死的——你能改图,改不了「图怎么跑」。
dsh:连「图怎么跑」(Agent Loop)、工具注册表、会话日志、审批策略、沙箱,全做成了可替换的插件。没有哪块是写死的。
| 维度 | 内容 |
|---|---|
| 定位 | 本地运行的 AI Agent 工作系统(agent harness) |
| 开源协议 | MIT |
| 当前状态 | 开发者预览版(v0.1.0-rc.5),官方明示会有破坏性变更 |
| 底层框架 | Cordis(Koishi 生态的插件内核) |
| 代码规模 | TypeScript monorepo(pnpm)+ Python,packages/ 下 221 个子包 |
| 上手命令 | npx @deepseek-ai/dsh web,默认 http://127.0.0.1:3080 |
WARNING
它是开发者预览版。官方 README 原文写得毫不含糊:THERE WILL BE COMPATIBILITY-BREAKING CHANGES.(会有破坏兼容性的变更。)现在的 API 和配置格式随时可能变,升级前务必看 Release Notes。
核心理念:没有需要打补丁的特权内核
理解 dsh,关键是理解它和 LangGraph 这类「同为框架」的工具,在扩展模型上的根本差异。
dsh 反其道而行——它没有「引擎」和「插件」的边界,连引擎本身都是插件。官方架构文档的原话是:
There is no privileged core to patch: you extend dsh by mounting a plugin beside the others, and registrations are effects that unwind when their plugin unloads.
没有需要打补丁的特权内核:你通过在其它插件旁挂载一个新插件来扩展 dsh,而注册本身是一种副作用,会随着插件的卸载而自动撤销。
具体来说,官方把下面这些全部做成了插件:
- 模型适配器(model adapter)
- 工具注册表(tool registry)
- 会话日志(session log)
- 审批策略(approval policy)
- 沙箱与文件系统
- Agent Loop 本身(the agent loop itself)
这意味着「换搜索引擎」「接自家模型服务」「改审批策略」这类 case,只需要改配置即可,不需要动框架代码。这也是它和 LangGraph 最本质的区别。
举个例子感受下「一切皆插件」意味着什么。 想在 Agent 里加一条「删文件前必须二次确认」的规矩:
- LangGraph:你得把这套审批逻辑画进你的图里——加一个
human_review节点,用interrupt_before让流程暂停等确认。至于「怎么识别危险命令」「怎么在 OS 层拦住它」,框架不提供,得自己写、自己接。能用,但审批是你的「业务代码」,不是框架的「能力」。 - dsh:审批策略(approval policy)本身就是框架内置的插件,OS 级沙箱也是内置的。你写一个新的审批插件把默认那个换掉,或者挂一个监听
tools/pre-execute事件的监听器,判断「这命令是不是在删东西」,是就拦住弹确认。这套东西和框架里其它插件平级,是「能力」而非「补丁」。
「换模型」同理:dsh 和 LangGraph 都支持 BYO 模型,但 dsh 把模型适配器也做成了可替换插件,接私有模型是「正门」而非「绕路」。
实现这一切的,是底层的 Cordis 框架:Cordis 是 Koishi 生态的插件内核,其设计来源于论文 A Programming Paradigm for Spatiotemporal Composability。
它的核心抽象是:插件向一个共享的 context 贡献「服务、类型化事件、以及可逆的副作用」,注册与卸载成对出现,天然支持动态加载和回滚。
架构:一棵启动时组合出来的插件树
dsh 每次启动,都不是「运行一个写死的程序」,而是按顺序叠加出一棵插件树。官方架构文档里这句概括得很准:
A running dsh is a plugin tree composed at boot from ordered layers.
一个正在运行的 dsh,是一棵在启动时由有序分层组合而成的插件树。
这套分层机制由三个概念构成:
Profile / Bundle / Patch
- Profile:一个命名组合,存放在 Harness home 目录下。它列出自己叠加了哪些 bundle、装了哪些树外插件、以及用户自己的
cordis.patch.yml。 - Bundle:Cordis 配置行 + 挂载代码的分发格式,保证它插入的东西能被上层继续 patch。
- Patch:对某一行配置做整体替换或插入新行。
还是用点餐来类比:bundle 是店里配好的套餐(dsh-base 就是「基础套餐」,dsh-web-app 是「加个 Web 界面」);profile 是你给这套组合起的名字(web、headless);patch 则是你在订单上的备注——「基础套餐不要辣、再加个蛋」。备注写在最后、优先级最高,能把套餐里的默认项覆盖掉。你不用重做一份套餐,只要在备注里写清楚改哪项就行。
分层叠加的优先级从低到高是这样的:
空入口列表(empty entry list)
  └─ 每个 bundle(按 profile 声明的顺序)
       └─ profile 的 cordis.patch.yml
            └─ home 级的 cordis.patch.yml
                 └─ 命令行的 --patch overlay   ← 优先级最高
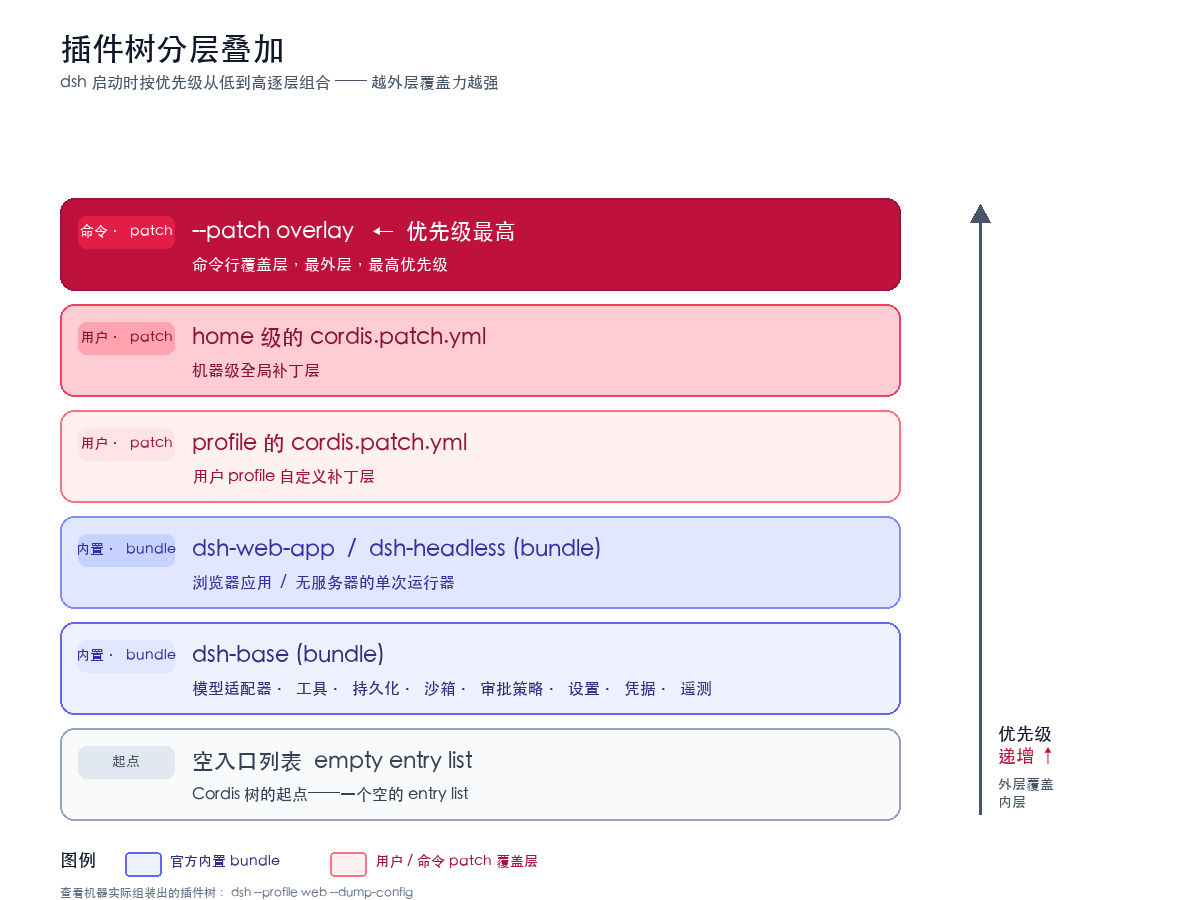
越靠后的层,优先级越高。官方内置了两个模板 profile:
dsh-base:每一套 profile 的第一层,包含模型适配器、工具、持久化、沙箱、审批策略、设置、凭据、遥测。dsh-web-app:在 base 之上叠加浏览器应用。dsh-headless:叠加一个无服务器的单次运行器(一次性任务)。
想看清自己机器实际会启动出什么样的树,官方提供了一个命令:
dsh --profile web --dump-config
它打印出来的每一行配置,都可以用你自己的 patch 去覆盖。这就是「改配置不动代码」在工程上的落点。
NOTE
这里要先澄清一个容易混淆的点:profile 本身没有「执行顺序」,它只有「组装顺序」。profile 是启动时(boot)的静态组合——它决定的是「加载哪些插件、以什么顺序叠加」,也就是上面这张图。真正有「执行顺序」的,是运行时的事件监听器,下面马上展开。
运行时:waterfall 事件与洋葱模型
看到「一层套一层、外层覆盖内层」,熟悉 Node 的同学应该会联想到中间件的洋葱模型。这个直觉是对的,而且 dsh 里其实藏着两层洋葱。
第一层是「静态的洋葱」——也就是上面的分层叠加。 它像洋葱皮一样:bundle 是内层、patch 是外层,外层覆盖内层,顺序即优先级。这和 Koa 中间件「按注册顺序串成一链」的组织方式很像。
第二层是「动态的洋葱」——运行时的 waterfall 事件。 这才更像我们平时说的 Koa 洋葱模型。架构文档明确写了,agent/pre-step、agent/request、llm/stream 以及三个 tools/* 事件都是 waterfall:
agent/pre-step,agent/request,llm/stream, and the threetools/*events are waterfalls, whose listeners must callnext()to delegate.
agent/pre-step、agent/request、llm/stream以及三个tools/*事件是瀑布式的,监听器必须调用next()才能把控制权委托给下一个监听器。
这里的「监听器」不是 profile,而是插件通过 ctx.on() 在某个事件上注册的回调。同一个事件(比如 agent/request)可能有多个插件各自注册了监听器,它们按注册顺序串成一条链,next() 就是把控制权交给这条链上的下一个监听器,而不是「下一个 profile」。
注册顺序由插件的加载顺序决定——Cordis Primer 的 dispatch modes 表写得很明确:waterfall 事件的监听器按 registration order(注册顺序)执行。所以 profile 和 next() 之间是间接关系:
profile 决定加载哪些插件 → 插件加载顺序决定监听器注册顺序 → 注册顺序决定
next()链的顺序。profile 是「组装单元」,不是「执行单元」。
还有两点值得记下:插件加载顺序不是「在 patch 里排第几行」这么简单,而是通过 inject 声明服务依赖推导出来的(load order is expressed through service requirements);waterfall 里监听器若不调用 next() 就返回,等于短路——后续监听器不再执行。
这个 next() 和 Koa 中间件的 await next() 在语义上是同一件事:
// Koa / Node BFF 中间件:洋葱模型
app.use(async (ctx, next) => {
  // 进入时:处理请求
  await next();
  // 回溯时:处理响应
});
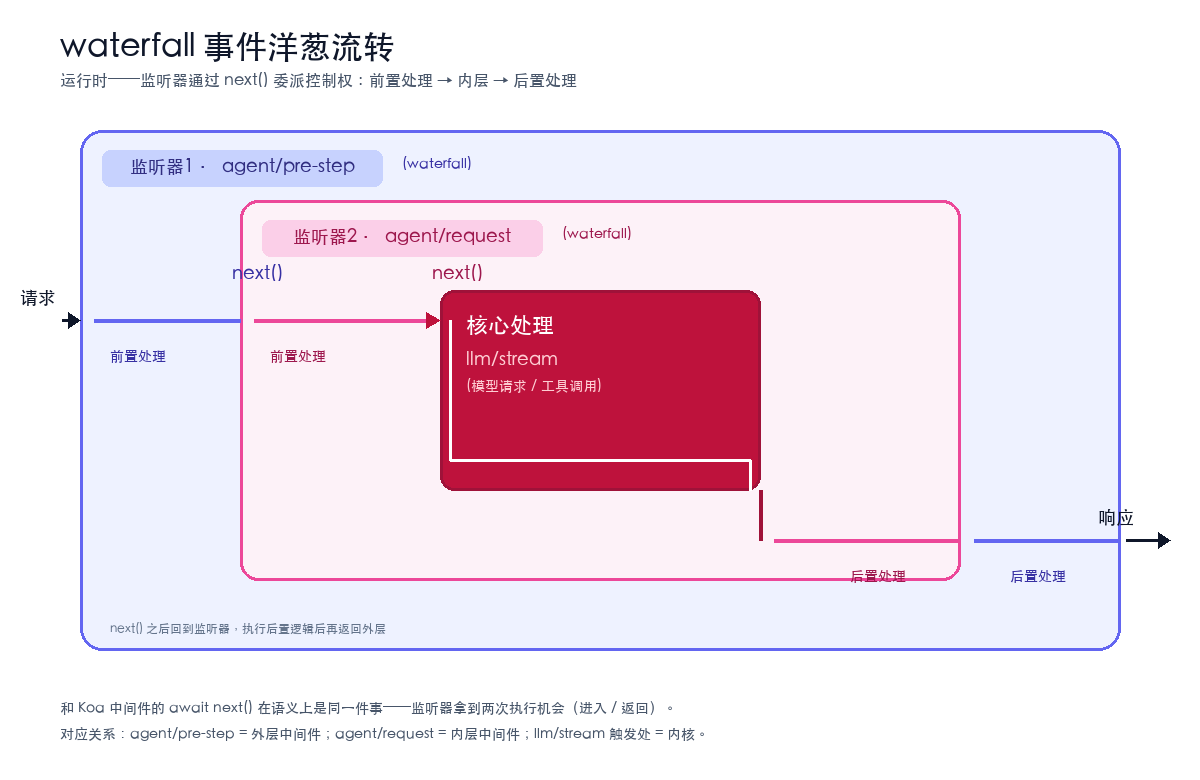
对应到 dsh,一个插件可以监听 agent/request,在 next() 之前改写请求、在 next() 之后再加工返回的流——和中间件「前置 / 后置」两次执行机会一模一样。
用三个真实会写的监听器把它具象化。假设有三个插件各自在 agent/request 上注册了监听器,按加载顺序排成一条链:
// 监听器 A:记日志(顺序第 1)
ctx.on('agent/request', (req, next) => {
  log('请求发出前', req);
  const res = next(); // 交给 B
  log('请求返回后', res); // B、C 都跑完才回到这里
  return res;
});

// 监听器 B:给 prompt 脱敏(顺序第 2)
ctx.on('agent/request', (req, next) => {
  req.prompt = mask(req.prompt); // 前置:把手机号打码
  return next(); // 交给 C
});

// 监听器 C:统计 token 成本(顺序第 3)
ctx.on('agent/request', (req, next) => {
  budget.before(req);
  const res = next(); // 最后真正触发模型请求
  budget.after(res); // 回程时统计实际花费
  return res;
});
一次请求的流转顺序就是:A 前置 → B 前置 → C 前置 → 模型 → C 后置 → B 后置 → A 后置。这就是上图的洋葱:C 是「最里层」,A 是「最外层」,next() 是那根把控制权往内层递、再原路收回来的线。谁先谁后,由它们被加载(注册)的顺序决定,跟它们写在哪份 patch 里没有直接关系。
所以两者「很类似」,但要说清楚类似在哪:分层叠加像洋葱的「皮」(结构上的嵌套),waterfall 事件才像洋葱的「流转」(执行上的嵌套,靠 next() 传递控制权)。 前者决定「最终组装成什么样」,后者决定「一次请求怎么流转」。
Capability Seams:能力缝
dsh 里有一个很有意思的概念叫 seam(能力缝)——一个可替换能力,由三个角色组成:
- Service Definition:声明接口;
- Service Provider:实现接口;
- Consumer:使用接口(通常是一个面向模型的工具)。
架构文档里对 seam 的价值有一句很精到的总结:
Seams are why one provider swap changes the whole product. Filesystem and subprocess providers share one execution world, so pointing them at a remote sandbox moves Bash, PTY, and LSP with them, with no provider forks.
能力缝是「换一个 provider 就能改变整个产品」的原因。文件系统和子进程 provider 共享同一个执行世界,所以把它们指向远程沙箱,Bash、PTY 和 LSP 会一起被搬过去,而不需要 fork 任何 provider。
换句话说,你在本地跑还是丢进远程沙箱跑,在 dsh 里是同一种抽象下的两种 provider,切换成本极低。
还是拿具体场景说话:开发时你想让 Agent 在本机改文件、跑命令;上了生产,又想让同一个 Agent 跑在一个隔离的远程沙箱里,别碰真机。在 dsh 里,这俩只是「文件系统 / 子进程」这个 seam 的两个 provider——改一行配置,把 provider 从「本地」指到「远程沙箱」,Bash、PTY、LSP 这些能力会跟着一起切过去,Agent 的代码一行不用动。这就是 seam 的「换一个 provider 改变整个产品」。
Session Log:模型可见即已记录
dsh 的会话日志是 append-only 的 SessionEvent 流,模型看到的上下文正是从这条流里投影出来的。架构文档里有一条硬性不变量:
Model-visible means logged. Anything that reaches a model request must be reconstructable from the log, and a runtime invariant asserts it.
「模型可见」即「已记录」。任何进入模型请求的内容都必须能从日志中重建,并且由一个运行时断言来保证这一点。
这条约束的工程价值很大:fork、resume、transcript 导出、遥测、持久化,全都从同一条日志流派生。它保证了会话可复现——这是很多同类工具做不到的。
换句话说:dsh 会把「发给模型的每一段内容」都当成一条条流水账记下来,并且用代码强制保证——只要进了模型眼睛的东西,就一定能在账本里找到。于是「这条会话能不能像 git 分支一样 fork 出去另起一路」「中断后能不能原样恢复」「事后能不能导出完整记录做审计」,全都可以无条件获取。
换成 LangGraph,checkpointer 存的是 State 快照,能断点恢复,但「模型到底看过什么」这一层,不如 dsh 的事件流那样被强制、完整地记下来。
dsh 的特点
把上面的架构梳理一遍,dsh 的特点可以归纳成下面几条:
一切皆插件,无特权内核:模型、工具、会话日志、沙箱、审批策略、Agent Loop 全部插件化,都能从配置层面替换。
分层 patch 组合:profile → bundle → patch →
--patch的多层叠加,改行为不 fork 代码。BYO 模型(Bring Your Own Model):框架本身不带模型,可接 DeepSeek、Anthropic、OpenAI 等目录提供方,也可配任意 OpenAI 兼容端点,甚至通过
input: [text, image]声明视觉能力。能力缝抽象:文件系统 / 子进程 / 子代理等能力通过统一 seam 抽象,换 provider 即可整体切换执行环境。
强可观测性与可复现:append-only 会话日志 + 「model-visible means logged」运行时不变量,支撑 fork / resume / 审计。
完整的内置 Agent 能力:工具(tools)、技能(skills)、子代理(subagent)、工作流(workflow)、目标(goal)、MCP 客户端、进程沙箱。
多入口:Web UI(主推上手路径)、headless CLI(一次性任务)、Python SDK(进程内驱动)。
OS 级沙箱:Linux 用 Landlock / bubblewrap,macOS 用 Seatbelt,Windows 用 ACL 受限令牌。
与 LangChain / LangGraph 的区别
先上一张对比表:
| 维度 | DeepSeek Harness | LangGraph | LangChain (LCEL) |
|---|---|---|---|
| 核心抽象 | 插件树 + 事件 | 图(节点 + 边)+ State | 链(Runnable 管道) |
| 控制流 | 隐式(事件 + 监听器注册顺序) | 显式(图的拓扑,含条件边) | 显式(固定 DAG,无环) |
| 循环 / 分支 | 内置 Agent Loop(可替换) | 有环图、条件路由 | 无环 |
| 状态管理 | append-only 会话日志 | 显式 State + checkpointer | 无共享状态 |
| 引擎可替换 | 是(无特权内核) | 否 | 否 |
| 沙箱 / 审批 | 内置 OS 级沙箱 + 审批插件 | 需自行实现 | 需自行实现 |
| 成熟度 | 开发者预览 | 生产级 | 生产级 |
| 主语言 | TypeScript + Python | Python(+ JS) | Python(+ JS) |
最本质的区别:你能改「图」,还是能改「引擎」
LangGraph 的核心心智模型是「把 Agent 画成一张图」:
from langgraph.graph import StateGraph, START, END
from typing import TypedDict

class AgentState(TypedDict):
    messages: list

def call_llm(state): ...   # 节点:调模型
def call_tool(state): ...  # 节点:调工具
def route(state):          # 条件边:按模型输出决定下一步
    return "call_tool" if state["messages"][-1].tool_calls else END

graph = StateGraph(AgentState)
graph.add_node("llm", call_llm)
graph.add_node("call_tool", call_tool)
graph.add_edge(START, "llm")
graph.add_conditional_edges("llm", route)   # 运行时路由
graph.add_edge("call_tool", "llm")          # 工具后回到模型 → 形成循环
app = graph.compile()
这段代码能自由定义节点、边、条件路由、循环——但 StateGraph 怎么编译、节点怎么调度、状态怎么 checkpoint,这些执行机制是 LangGraph 库写死的。你是在「引擎之上」搭图,不是在「引擎之内」做手脚。
dsh 反过来:core/agent-loop 只是一个「默认驱动」,工具注册表、会话日志、审批策略、沙箱全是插件。你不是在某个写死的引擎上搭图,而是连引擎本身都可以换掉。
控制流:显式画图 vs 隐式事件
LangGraph 的控制流是显式的:谁连谁、什么时候循环、什么时候分支,全在图里写清楚,一眼能画出拓扑。
dsh 的控制流是隐式的:没有「图」这个概念。行为由「事件 + 监听器注册顺序」决定——一次 agent/request 会穿过哪些监听器、谁先谁后,取决于哪些插件监听了它、按什么顺序注册。好处是极致的可组合(新插件插进来就自动参与流转),代价是「整体流程」不像 LangGraph 那样一张图看得明明白白。
状态:State 对象 vs 会话日志
- LangGraph 用显式 State 对象(TypedDict)承载所有中间数据,配 checkpointer 做持久化、断点恢复、time-travel。
dsh用 append-only 会话日志(SessionEvent流)作为唯一事实源,模型上下文从日志投影,fork / resume / 审计全从这条流派生。
两者都解决了「有状态、可恢复」,但路子相反:LangGraph 是「把状态摆上台面」,dsh 是「把历史完整记下来」。
一句话区分
LangChain 是「链」,LangGraph 是「图」,
dsh是「插件树」。前者让你在写死的引擎上自由编排,后者让你连引擎都能换。LangGraph 成熟稳、生态大;dsh更底层、更开放,但还处在开发者预览。
优缺点
优点
- 极致的可组合与可替换:无特权内核 + 分层 patch,改行为不 fork 代码,这是它相对 LangGraph 最大的护城河。
- 模型无关:BYO 模型,接私有化部署、自建网关、公司内部模型服务都是「原生」路径。
- 强可复现与可审计:append-only 会话日志 + 运行时断言,fork / resume / 审计天然成立。
- 多入口覆盖:Web UI 上手、headless CLI 跑一次性任务、Python SDK 进程内驱动,同一套能力三种用法。
- OS 级沙箱:Landlock / Seatbelt / ACL 三平台真实沙箱,不只是「目录白名单」。
- MIT 开源:无授权顾虑,可深度改造。
缺点
- 开发者预览,API 不稳:官方明示有破坏性变更,现在的插件和配置格式可能下个版本就失效,不适合生产关键链路。
- 上手门槛高:要真正发挥它,得理解 Cordis、插件树、patch 叠加这些概念;只想「开箱写代码」的人会被劝退。
- 生态早期:插件少、教程少、社区刚起步,遇到问题能参考的实践有限。
- 产品化程度不足:UI、默认能力打磨、文档成熟度,都还比不过 LangChain / LangGraph。
- 效果依赖你接入的模型:它本身不带模型,harness 做得再好,产出质量的上限仍由你接的那个模型决定。
实用场景
结合它的特点,我认为 dsh 当前更值得关注的是下面几类场景:
1. 私有化 / 自建模型驱动的 Coding Agent
如果你的团队出于合规或成本,需要把 Coding Agent 跑在自建模型或公司内部网关后面,dsh 的 BYO 模型 + 内置沙箱 + 可替换审批,是一条比「在 LangGraph 里自己搭审批和沙箱」更省事的路。
2. 把 Agent 能力嵌入自己的产品
Python SDK 通过 stdio 上的 JSON-RPC 驱动内置运行时,你可以把 dsh 当成一个「Agent 引擎」塞进自己的工具链、平台或服务里,复用同一套插件能力,而不必自己造轮子。
3. 深度定制 Agent Loop / 工具 / 审批策略的团队
当你的需求超出了「画一张图、加几个节点」能覆盖的范围——比如自定义循环语义、自定义审批流、替换整个执行环境——dsh 的插件树 + 能力缝是唯一能干净落地的开源方案。
4. 需要强可审计、可复现会话的场景
「model-visible means logged」这条不变量,让 dsh 天然适合对可追溯性有要求的场景:金融、合规、以及任何「出了事要能回放 Agent 当时到底怎么想的」的场合。
5. Agent 框架研究与学习
如果你想搞懂一个 Agent harness 的架构应该怎么设计——事件系统、能力缝、会话日志、分层组合——dsh 是目前开源里架构最干净、最值得读的样本之一。
而反过来说,如果你只需要一个成熟的图编排框架,LangGraph 目前仍是更稳的选择:生产级、生态大、文档全。dsh 现阶段更适合「想把 Agent 框架的底层也一并掌控」的开发者尝鲜。