AI Coding 实践:上下文、任务组织与验收闭环
 Ryan
本文目录
NOTE
相信大家在使用 AI Coding 的时候,都会遇到 模型在不确定时自动脑补、长任务持续漂移、看起来解释清楚但实际上没有做对 之类的问题。这些问题本质上都可以拆解成以下三个维度:
- 上下文怎么给:Agent 拿到的上下文是否足够准确
- 任务怎么组织:执行任务时有没有被放进一个稳定的推进机制里
- 结果怎么验收:产出的结果有没有被一个明确的验收闭环约束住
上下文怎么给
从 Vibe 到 Spec 再到 Harness
这是三种很典型的 AI Coding 范式,本质区别不在于“模型本身是否更聪明了”,而在于给予了模型不同程度的自由度及约束。
| 范式 | 本质 | 适合任务 | 你需要给 AI 的东西 | 主要风险 | 典型产出 |
|---|---|---|---|---|---|
| Vibe Coding | 快速试探和迭代 | 小改动、原型、demo、低风险修补 | 明确边界、少量上下文、快速验证命令 | 容易漂移,容易把“跑起来了”误当成“做对了” | 一个可运行初版 |
| Spec-Driven Development | 先收敛意图,再执行实现 | 中等复杂度功能、模块改造、替换依赖 | 目标、约束、非目标、验收方式 | Spec 沉淀过多且不维护,会反过来污染上下文 | 一份设计文档 + 分步实现 |
| Harness Loop | 把执行放进循环系统 | 长链路、高风险、跨模块、可持续推进的任务 | 任务拆分、外置状态、质量把关、回滚点 | 不把关质量,只会把错误自动化放大 | 一个可重复运行且不失控的执行闭环 |
这其实是一条很清晰的演化线:
Vibe 回应:先把东西做出来
Spec 回应:需求容易漂移
Harness 回应:长任务会失控、会中断、会越做越乱
彼此不是互斥关系,而是控制强度逐级上升,逐步补全前一阶段的短板。
Spec:规范驱动开发 (SDD)
NOTE
一句话描述:用结构化文档把任务从「对话驱动」升级为「状态驱动」,通过外部约束来稳定模型在多步开发中的行为。
三个核心原则
意图先行:先明确「做什么」再讨论「怎么做」
规格外置:把目标、边界、约束、验收从对话里抽出来
渐进式细化:从高层需求到技术实现,通过渐进式细化避免一次性生成的局限性
这类方法的价值,不是让 AI 更有创造力,而是让它少靠猜、多靠对齐。
Understanding Spec-Driven-Development: Kiro, spec-kit, and Tessl 里提到,这个概念本身还在快速演化,行业里对 “spec-driven development” 的定义并没有完全定型。它更像一类实践,而不是一套已经成熟、定型的方法论,需要辩证看待。
the definition of ‘spec-driven development’ (SDD) is still in flux.
“规范驱动开发”(SDD)的定义仍在不断变化。
OpenSpec:把变更状态沉淀到文件系统
OpenSpec 是一个很典型的 Spec 落地方式。
它会把一次变更拆成 proposal / specs / design / tasks 这几类文档,再通过 propose -> apply -> archive 这样的流程,把一次改动沉淀成显式、可审阅、可版本化的状态。
换句话说,它在做的一件事是:把模型执行依赖的关键状态,从“会话记忆”外置到“文件系统”上。
一个典型的 Spec 文件系统结构,大概长这样:
openspec/
├── project.md              # 项目约定
├── specs/                  # 当前系统的真实规格 - 已构建的内容
│   └── [capability]/           # 单一专注功能
│       ├── spec.md             # 需求和场景
│       └── design.md           # 技术模式
├── changes/                # 每次变更的提案、任务清单及规格增量
│   ├── [change-name]/
│   │   ├── proposal.md         # 提案
│   │   ├── tasks.md            # 实施清单
│   │   ├── design.md           # 技术决策(可选;见标准)
│   │   └── specs/              # 增量变更
│   │       └── [capability]/
│   │           └── spec.md         # ADDED/MODIFIED/REMOVED
│   └── archive/                # 归档:已完成的变更
这种方式的优点很直接:
当前任务依赖什么,不再只存在聊天上下文里
改动为什么做、准备怎么做、做到哪一步,都可以被审阅和追踪
对于多轮执行、跨会话恢复、任务交接,会稳定很多
NOTE
但代价同样明显:过多的约束会引入更高的系统复杂度及维护成本,缺乏治理容易导致文档膨胀、上下文噪声和状态失真等问题。 Augment Code 在其文章 What spec-driven development gets wrong 中指出,代码才是最可靠的真实来源,而 Spec 虽然很有用,但一旦失去维护,它就会快速腐烂。
因此,个人更倾向于把 Spec 看成中短周期任务的执行支架,而非长期沉淀的系统记忆;其核心价值在于「约束执行过程」。
Superpowers:用流程换稳定性
Superpowers 代表的是另一种风格。
它没有很重的文件规范体系,而是更偏向一套工作流:先收敛问题、再写计划、最后执行。
官方仓库给出的典型链路是:brainstorming -> writing-plans -> subagent-driven-development / executing-plans。
我自己也常在使用上,先让 Agent 在 Plan mode 或 brainstorming 阶段把问题梳理清楚,产出结构化的 plan 和 todo list,再开始执行。
NOTE
但 Superpowers 的代价也很明显:它会带来额外的上下文和执行开销,实际是在用流程、时间和上下文,换取更稳定、可控的执行。
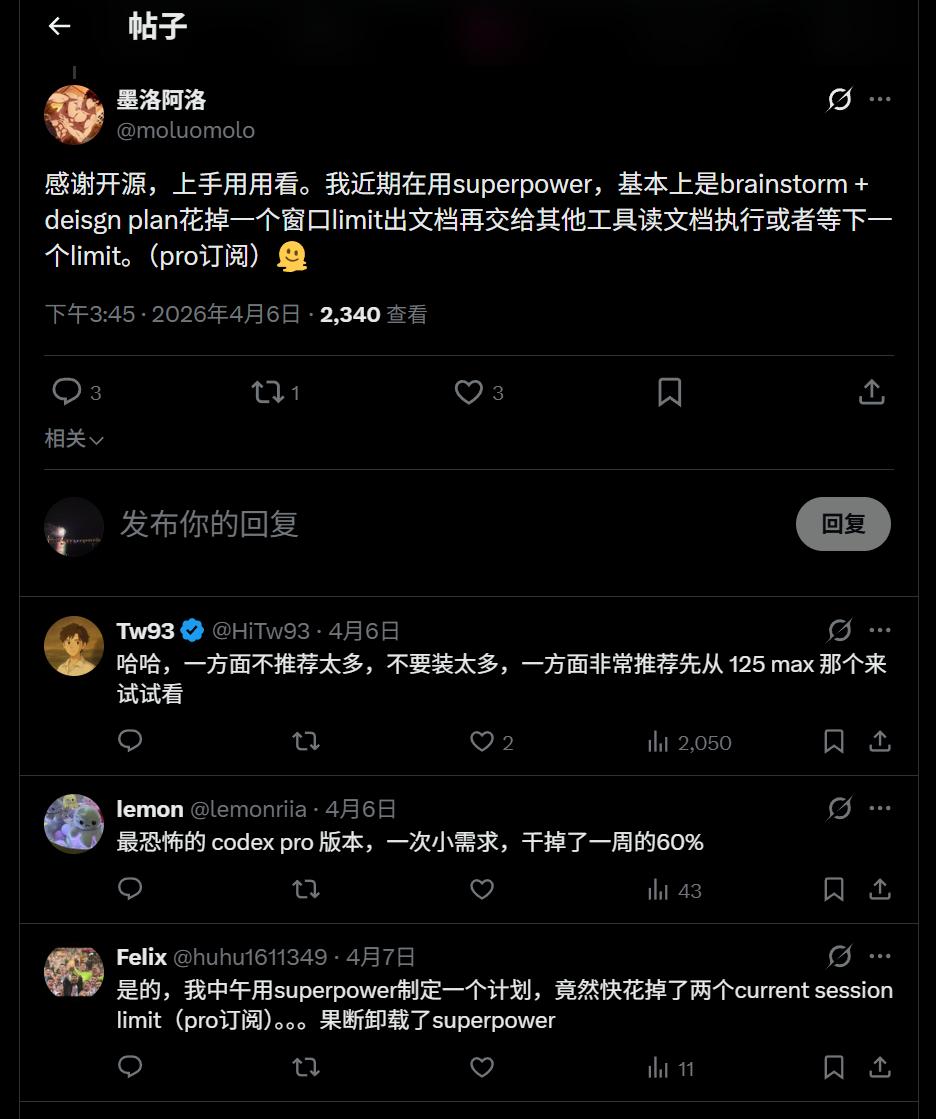
这类方式更适合类似于 长任务、容易偏航、需要阶段性检查 的场景,而不是一个几分钟能改完的小问题。
# 安装 Skills
npx skills add https://github.com/obra/superpowers
上下文不是越多越好,而是越准越好
NOTE
高质量的上下文供给对于模型行为是至关重要的。好的上下文设计可以让模型更快理解任务、减少幻觉、提升输出质量。但过多的上下文同样会产生噪声,导致模型注意力分散。
Anthropic 在 Effective context engineering for AI agents 中提到:context 是关键资源,但也是有限资源。随着 token 增加,模型的注意力预算会被不断消耗,收益不是线性增长,反而会出现边际递减。
Context is a critical but finite resource for AI agents.
上下文是人工智能智能体至关重要但有限的资源。
as the number of tokens in the context window increases, the model’s ability to accurately recall information from that context decreases.
随着上下文窗口中 tokens 数量的增加,模型从该上下文中准确回忆信息的能力会下降。
换句话说,一旦上下文过长,混入过多信息后,问题就不再是“模型看不到”,而是它无法稳定判断什么才是真正重要的信号。
所以,上下文设计的重点不是“把资料都喂进去”,而是两件事:
先把最关键的信息放到模型最容易看到的位置
再让模型知道,剩下的信息应该去哪里找
AGENTS.md
AGENTS.md 通常是模型的默认入口,最适合放高密度、控制性强、且无法从代码中直接推导的信息,例如:
项目架构入口
关键模块索引
默认命令入口
禁区与约束
最低完成标准
范围控制原则
它不适合承载大段背景介绍,也不适合把 docs 里的内容再重复一遍。因为 AGENTS.md 一旦什么都写,就会从“控制入口”退化成“噪声入口”,它应该遵循最小必要原则进行设计。
docs
个人理解 docs 是一个分层、按需加载的上下文系统,用于沉淀仓库关键的长期记忆。
主要用于积累长期稳定、且会持续影响任务判断的知识,比如:
架构文档:系统结构、关键数据流、核心边界
模块文档:模块职责、关键入口、相互依赖
工程规范:验证方式、评审规则、工作流约定
这样做的好处是,模型不需要一开始就读完整个仓库,而是先知道“应该先看哪里”。
模型的上下文焦虑
上下文窗口变大,并不等于长任务问题自然消失。
Anthropic 在 Harness design for long-running application development 里提到一个很有意思的现象:随着上下文不断膨胀,模型可能会出现一种类似“该收尾了”的倾向,开始提前总结、避免继续展开、或者保守地宣布任务“基本完成”。这类现象背后并不一定是模型真的判断任务完成了,更可能是上下文压力驱动下的行为收缩。
First is that models tend to lose coherence on lengthy tasks as the context window fills (see our post on context engineering). Some models also exhibit "context anxiety," in which they begin wrapping up work prematurely as they approach what they believe is their context limit. Context resets—clearing the context window entirely and starting a fresh agent, combined with a structured handoff that carries the previous agent's state and the next steps—addresses both these issues.
首先,随着上下文窗口被填满,模型在处理冗长任务时往往会失去连贯性(详见我们关于上下文工程的文章)。部分模型还会表现出“上下文焦虑”,即当它们接近认为的上下文上限时,就会提前结束工作。上下文重置——完全清空上下文窗口并启动一个新的智能体,同时结合结构化的交接来传递前一个智能体的状态和后续步骤——可以解决这两个问题。
这也是为什么长任务里真正有效的做法,通常不是单纯继续喂更多上下文,而是做三件事:
压缩:把历史执行过程总结成高保真摘要
外置:把目标、状态、验证、风险显式写进 repo 文件
重置:当任务进入新阶段时,通过 handoff 让新会话接手
原文的总结也很明确:对于长任务来说,单纯 compaction 并不总是够用;很多时候 **带着结构化交接的上下文重置 **比继续压缩膨胀的上下文更稳,因为它保留状态并给了模型更干净的上下文。
所以个人理解 真正稳定的长任务,不能只靠模型记忆,建设可“沉淀”、“恢复”、“交接” 的系统或许更关键。
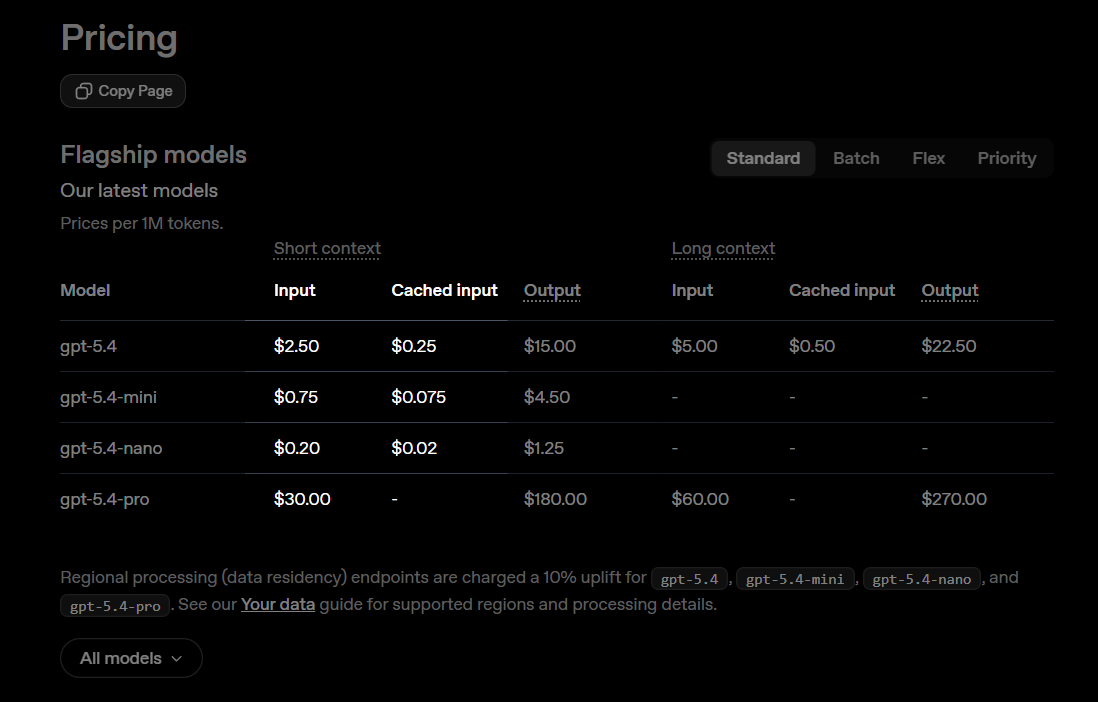
这里也有值得注意的点:不要频繁手动压缩上下文、同一会话窗口最好不要切换模型 在大多数 IDE / CLI 的多轮会话里,新输入通常只是追加在后面,稳定的前缀在模型缓存机制下能更容易复用缓存、减少重复计算。如果中途压缩上下文形成新的摘要,或者切换模型继续同一任务,由于 prompt cache 依赖前缀匹配,会导致原本可复用的上下文失效,继而引起 token 计算成本上升。
所以一般建议 **尽量保持单一会话的连续性,把压缩留给系统处理或阶段性交接,**以及 把不同模型的任务拆到不同会话窗口。
任务怎么组织
长任务的项目编排
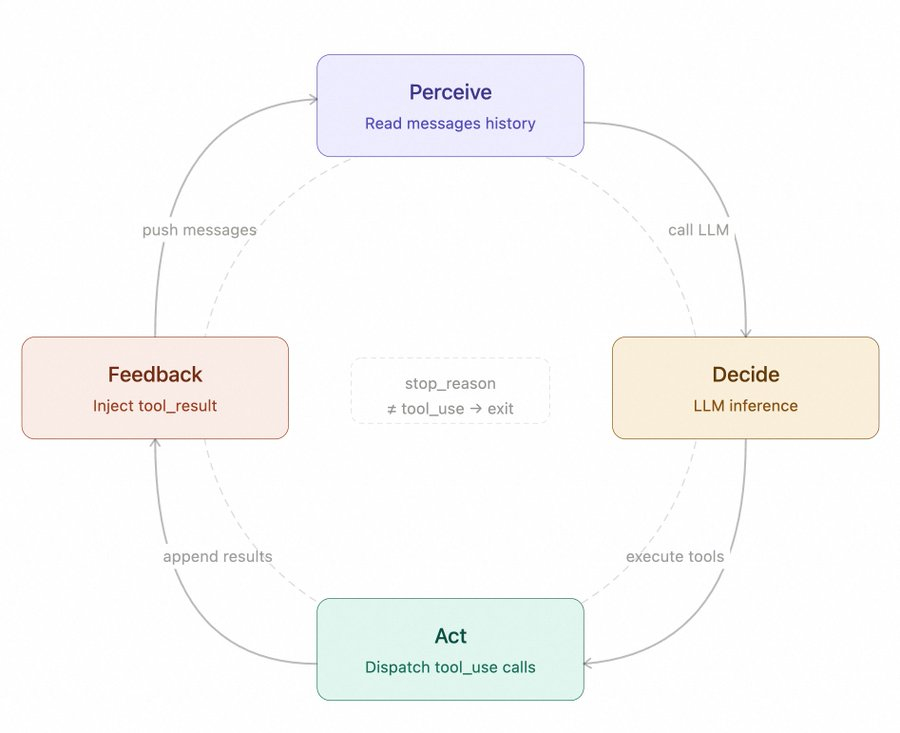
OpenAI 在 Run long horizon tasks with Codex 里明确指出,真正让长任务稳定推进的,往往不是一个更长的 prompt,而是模型所处的 agent loop。
Long-running work is less about one giant prompt and more about the agent loop the model operates inside.
长期运行的工作并非主要依赖一个巨型提示词,而更多取决于模型所运行的智能体循环。
他们通过以下流程编排和文件设计,使得 GPT-5.3-Codex 在“Extra High”推理级别下能连续运行了约 25 小时,共计消耗了约 1300 万 tokens,生成约 3 万行代码。核心是把 agent loop 直接拆成了 7 步:
Plan
Edit code
Run tools (tests / build / lint)
Observe results
Repair failures
Update docs / status
Repeat
当 Agent 一直处于一个有反馈、有修复、有状态更新的循环里工作, 它便获得真实反馈、外置状态,以及跨时间持续可纠偏的能力。
源码:https://github.com/derrickchoi-openai/design-desk/blob/main/docs/prompt.md
repo/
├── AGENTS.md            # 长期规则:目录、命令、约束、done 定义
├── Prompt.md            # 定义目标和交付物,spec + deliverables
├── Plan.md              # 做 milestone 和验证,milestones + validations
├── Implement.md         # 作为运行手册,要“follow the plan, keep diffs scoped, run validations, update docs”
└── Documentation.md     # 作为共享记忆和审计日志,记录状态、决策、运行方式和 follow-ups。
以下是一个桌面应用项目上下文编排示例。相比上面官方仓库的最小闭环,它进一步把不同职责的文档模块拆开,并外置计划与检查点。
长期稳定信息 放在
AGENTS.md和docs/本轮任务计划 放在
PLANS/ACTIVE.md怎么执行、怎么评审、怎么交接 放在
RUNBOOKS/验证入口 固定成脚本,比如
validate.sh / smoke.sh
这样即使面对任务异常中断或者跨会话的场景,也能快速恢复上下文继续任务。
desktop_app/
├── AGENTS.md                         # AI 协作入口:全局规则、阅读顺序、关键边界
├── docs/                             # 长期记忆:只放稳定知识
│   ├── INDEX.md                      # 文档导航入口:告诉人和 agent“先读什么”
│   ├── ARCHITECTURE/                 # 架构文档:解释系统级结构
│   ├── MODULE/                       # 模块地图:按仓库子系统解释目录职责
│   └── ENGINEERING/                  # 工程规范:验证、评审、工作流约定
├── PLANS/                            # 执行期计划:进行中的任务计划,不属于长期记忆
│   ├── ACTIVE.md                         # 当前活跃计划:本轮任务列表、milestone、执行记录
│   └── _TEMPLATE.md                      # 计划模板:新任务复制这个起步
├── RUNBOOKS/                         # 动作协议:告诉 agent 和开发者“具体怎么做”
│   ├── Handoff.md                        # 交接协议:结束时要交付什么信息
│   ├── Implement.md                      # 实施协议:开始改动前后必须做哪些动作
│   └── Review.md                         # 评审协议:自检/互检时遵循的步骤
└── .agents/                          # Agent 协作资产:角色与仓库级 skills
    ├── roles/                        # 子代理角色卡
    │   ├── implementer.md
    │   ├── reader.md
    │   ├── reviewer.md
    │   └── tester.md
    └── skills/                       # 仓库级 skill:沉淀可复用工作流
        ├── code-review.md
        └── smoke-test.md
Agent Teams / Sub Agents
这两个能力都不是“派生越多越高级”,而是在单 Agent 已经开始吃力时,引入受控分工。
OpenAI 在 A practical guide to building agents 里建议,默认先从更简单的系统开始,只有当复杂度已经明显超过单 Agent 能稳定处理的范围,再考虑更复杂的** Agents 编排**。
maximize a single agent’s capabilities first.
先最大化单个智能体的能力。
Anthropic 在 How we built our multi-agent research system 中也提到多 Agents 的优势以及显著增加的 token 成本问题。
There is a downside: in practice, these architectures burn through tokens fast. In our data, agents typically use about 4× more tokens than chat interactions, and multi-agent systems use about 15× more tokens than chats. For economic viability, multi-agent systems require tasks where the value of the task is high enough to pay for the increased performance. Further, some domains that require all agents to share the same context or involve many dependencies between agents are not a good fit for multi-agent systems today. For instance, most coding tasks involve fewer truly parallelizable tasks than research, and LLM agents are not yet great at coordinating and delegating to other agents in real time. We’ve found that multi-agent systems excel at valuable tasks that involve heavy parallelization, information that exceeds single context windows, and interfacing with numerous complex tools.
这里存在一个缺点:在实际应用中,这些架构会快速消耗 tokens。在我们的数据中,**智能体通常比聊天交互多消耗约 4 倍的 tokens,而多智能体系统比聊天多消耗约 15 倍的 tokens。**为实现经济可行性,多智能体系统需要任务价值足够高,足以覆盖性能提升所带来的成本。此外,如今一些要求所有智能体共享同一上下文或智能体间存在大量依赖关系的领域,并不适合采用多智能体系统。例如,大多数编码任务的真正可并行化任务数量少于研究类任务,且大语言模型智能体目前还难以实时协调并指派任务给其他智能体。我们发现,多智能体系统在以下高价值任务中表现出色:涉及高度并行化的任务、超出单上下文窗口的信息处理,以及与众多复杂工具的交互。
换句话说,多 Agent 当然能带来好处,但前提是:任务本身真的适合拆开并行推进。
任务天然可并行
比如:对一个 Electron 需求,同时派 2~3 个 Agent 分别梳理 main / renderer / bridge 的影响面,最后由主 Agent 汇总成一份改动地图。
或者对一个复杂 PR,同时派不同 Agent 分别检查:安全风险、改动影响面、接口或 IPC 约定是否被破坏以及文档、脚本、配置是否需要同步更新。
子任务需要不同工作模式
此时 Sub Agent 的价值不只是“同时做几件事”,而是 把不同的工作方式隔离开。比如:
reader:只负责读代码、梳理依赖、识别影响面implementer:只负责小范围实现,避免顺手扩散改动tester:只负责补测试、跑验证、整理失败信息reviewer:只负责看 diff、看范围、看风险、看是否真的可合并
分离“执行角色”和“评判角色”
Anthropic 在 Harness design for long-running application development 中提到一个很现实的问题是:Agent 在评估自己产出的结果时,天然容易偏宽松。因此,分离角色是能改善长任务的稳定性的。
所以在后续实践中,大家可以尝试以下方式:
主 Agent 维护目标与总状态
子 Agent 做局部探索或局部实现
reviewer / evaluator 只负责判断结果是否达标
Anthropic 的 Multi-Agents 系统也是类似的编排模式:lead agent 负责计划与协调,subagents 负责并行执行,再把结果回收统一判断。
但也**不是所有任务都值得上 Agent Teams。**当任务边界不明确、子任务之间耦合度过高、或者当前上下文上限不是瓶颈时,多 Agents 只会把混乱放大。OpenAI 的建议本质上也是一样的:先把单 Agent 用好,再在确实需要时引入更多编排复杂度。
一个比较推荐的判断方式是:**先拆解任务计划和检查点,再决定要不要拆多个 Agent。**如果连检查点都拆不出来,多半还不到上 Agent Teams 的时候。
结果怎么验收(探索中)
TDD 测试驱动开发
在开始改代码之前,先明确完成预期。比如:
哪些功能必须能跑通
哪些边界情况必须覆盖
哪些旧功能不能被改坏
至少要通过哪些验证命令
OpenAI 在 Run long horizon tasks with Codex 中也有强调这一点:每个 milestone 后都要做验证,不是写完就算,而是验证通过后才能继续。 他们在总结里也直接把 tests / lint / typecheck / build 列成了持续验证的一部分。
结合到日常使用中,我计划尝试把他分成两个固定入口文件。这样的好处是对于日常任务,Agent 不需要每次都临时推断怎么验收,它只需要执行固定命令,把核心内容检查一遍。
validate.sh
只放“高频、稳定、核心”的测试用例,通常是:ESLint、typecheck、build、单元测试、必要的集成测试。
smoke.sh
检查启动和 P0 级别关键路径,比如:
应用能不能正常启动
首页能不能打开
核心操作能不能走通一遍
关键日志里有没有明显报错
测试入口的技术选型:CLI / MCP
MCP vs. CLI for AI-native development 总结得很清楚:
Summary: The CLI vs. MCP question is really a question about where you are in the development loop. CLIs fit the inner loop: fast, local, zero overhead. MCP servers fit the outer loop: external systems, shared infrastructure, structured access. Most teams need both.
CLI 与 MCP 的问题,本质上是关于你处于开发循环的哪个阶段。CLI 适用于内部循环:快速、本地、零开销。MCP 服务器适用于外部循环:外部系统、共享基础设施、结构化访问。大多数团队需要两者兼具。
此外,有一点值得注意的是,MCP is up to 32× more expensive than CLI. Here’s why we still use it. 通过 75 次基准测试,验证了 CLI 比 MCP 成本低 10-32 倍,可靠性也比 MCP 要强。
We ran 75 benchmark runs comparing CLI and MCP for AI agent tasks. CLI won on every efficiency metric — 10 to 32× cheaper, 100% reliable versus MCP’s 72%.
我们针对 AI 智能体任务开展了 75 次基准测试,对比 CLI 与 MCP 的表现。在各项效率指标上 CLI 均取得胜利——成本比 MCP 低 10 至 32 倍,且实现了 100% 的可靠性,而 MCP 的可靠性仅为 72%。
因此对于本地桌面应用这类测试场景,通过 CLI 暴露原子测试能力个人认为是更高效的。因为 MCP 这套协议更侧重于把现有能力暴露给外部 Agent 调用。
后续也可以尝试通过 CLI-Anything 将本地应用的原子能力 CLI 化,应用到测试环节中。
使用总结
仓库文档编排遵循最小必要原则:把长期稳定规则放进
AGENTS.md / docs,把本轮目标、状态、验证和风险外置到计划文件里。任务执行只提供当前阶段所需必要的上下文。
不要频繁手动压缩上下文,也不要在同一会话里来回切模型。
小任务先用轻量 Vibe,复杂一点再上 Spec,长任务需要规划好 Agent Loop,测试用例必不可少。
Sub Agents / Agent Teams 按需调用。
测试入口可以尝试使用 CLI,执行会更高效。
结语
突然意识到,人生某种程度上也像一个巨大的 self-attention。 未来始终被 mask 掉,我们看不见完整答案,只能带着过往沉淀下来的 KV cache,在一次次选择里,继续计算下一个 token 的概率分布。一路上,外界的反馈像 reward model,不断给我们的决定打分;而那些走过的弯路、吃过的亏、做过的修正,又像 actor loss,一点点更新我们面对未来的方式。 于是我们就在这样的迭代中,继续生成、继续修正、继续向前。 也许对更高的视角来说,我们漫长的一生,不过是一句话;人生里的每一个阶段,也不过是其中一个 token。可只有真正走到回头看的那一刻,才会明白,那些当时以为绕远的路、那些以为无意义的损失、那些反复修正的瞬间,最终都参与完成了属于自己的那次反向传播。
愿大家都能在自己的序列里,持续生成值得回看的内容。
也祝大家前程似锦,token 落处皆有意义,步步向前,最终收敛到属于自己的最好结果。